華宇在自然語言處理、法律人工智能、司法場景理解與數據治理方面的數據處理服務
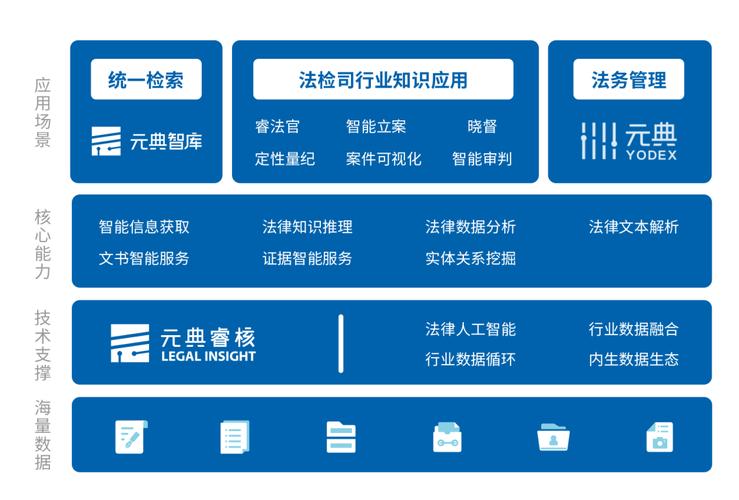
隨著人工智能技術的快速發展,法律行業正經歷著深刻的數字化變革。華宇作為深耕法律科技領域多年的領先企業,依托在自然語言處理、法律人工智能、司法場景理解以及數據治理等方面的核心技術能力,構建了全面而專業的數據處理服務體系,為法院、檢察院、司法行政機關、律所及企業法務等客戶提供高質量、場景化的數據服務支撐。
一、自然語言處理:法律文本的智能解析與生成
法律文書、證據材料、庭審筆錄等非結構化文本數據占據法律數據的絕大多數。華宇的自然語言處理(NLP)技術針對法律語言的特點進行了深度優化,能夠實現:
- 命名實體識別:自動提取案件中的當事人、法官、律師、金額、日期、法條等關鍵要素;
- 關系抽取:識別主體之間的法律關系,如原告與被告、合同雙方、侵權與被侵權等;
- 文本分類與聚類:對裁判文書、咨詢問答、合同條款進行自動歸類與主題發現;
- 摘要生成:快速生成案情摘要、爭議焦點歸納、判決要點提煉;
- 機器翻譯與OCR后處理:支持多語種法律文本翻譯,并對掃描文檔進行高精度識別與糾錯。
這些能力為后續的智能檢索、類案推薦、文書自動生成等應用提供了堅實的數據基礎。
二、法律人工智能:領域知識與模型的深度融合
華宇將法律知識圖譜與大規模預訓練模型相結合,構建了面向法律領域的人工智能平臺。在數據處理服務中,主要體現在:
- 法律知識圖譜構建:整合法律法規、司法解釋、案例、學術觀點等,形成可推理、可查詢的知識網絡;
- 智能問答與咨詢:基于法律條文和案例數據,為用戶提供精準的法律問題解答;
- 裁判預測與量刑輔助:通過對歷史裁判文書的數據挖掘,為法官提供類案參考和量刑建議;
- 合同審查與風險識別:自動分析合同條款,標記潛在風險點與不一致之處。
這些服務不僅提升了法律事務的處理效率,也為司法決策提供了數據驅動的智能支持。
三、司法場景理解:從數據到業務的全鏈路貫通
司法業務具有高度的場景化特征,不同環節對數據的需求差異顯著。華宇深入理解立案、審判、執行、信訪、獄政等核心場景,提供針對性的數據處理服務:
- 立案階段:自動識別起訴材料中的關鍵信息,輔助生成立案登記表;
- 審判階段:對庭審語音進行實時轉寫和語義分析,提取爭議焦點,推送相關法條與類案;
- 執行階段:分析被執行人財產線索、履行能力,輔助制定執行方案;
- 信訪與獄政:對信訪訴求進行情感分析與分類,對服刑人員數據進行風險評估與行為預測。
通過場景化的數據治理與理解,華宇幫助司法機關實現從“數據沉淀”到“數據賦能”的轉變。
四、數據治理:安全、合規、高質量的數據底座
法律數據涉及大量個人隱私、商業秘密和國家秘密,數據治理至關重要。華宇提供全生命周期的數據治理服務,包括:
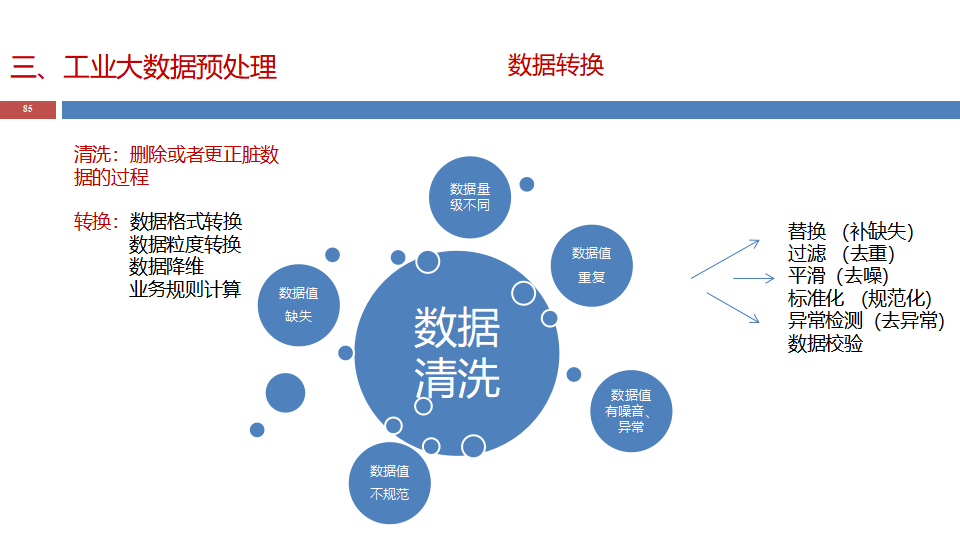
- 數據采集與清洗:多源異構數據的抽取、去重、標準化與質量校驗;
- 數據分類分級:根據敏感程度和業務價值對數據進行分級,實施差異化保護;
- 數據安全與隱私計算:采用脫敏、加密、聯邦學習等技術,確保數據“可用不可見”;
- 數據資產管理:建立元數據管理、數據血緣追蹤、數據質量監控體系;
- 合規咨詢:依據《數據安全法》《個人信息保護法》等法規,協助客戶建立合規的數據處理流程。
通過體系化的數據治理,華宇確保法律數據在安全合規的前提下發揮最大價值。
五、與展望
華宇在自然語言處理、法律人工智能、司法場景理解和數據治理四個維度的數據處理服務,形成了“技術—知識—場景—治理”的閉環能力。隨著大模型技術與法律業務的進一步融合,華宇將繼續深化數據服務能力,推動法律行業向智能化、標準化、安全化方向持續演進。
如若轉載,請注明出處:http://www.cstongwang.com/product/104.html
更新時間:2026-09-21 11:12:31